Der Fleck dort könnte eine Koralle sein
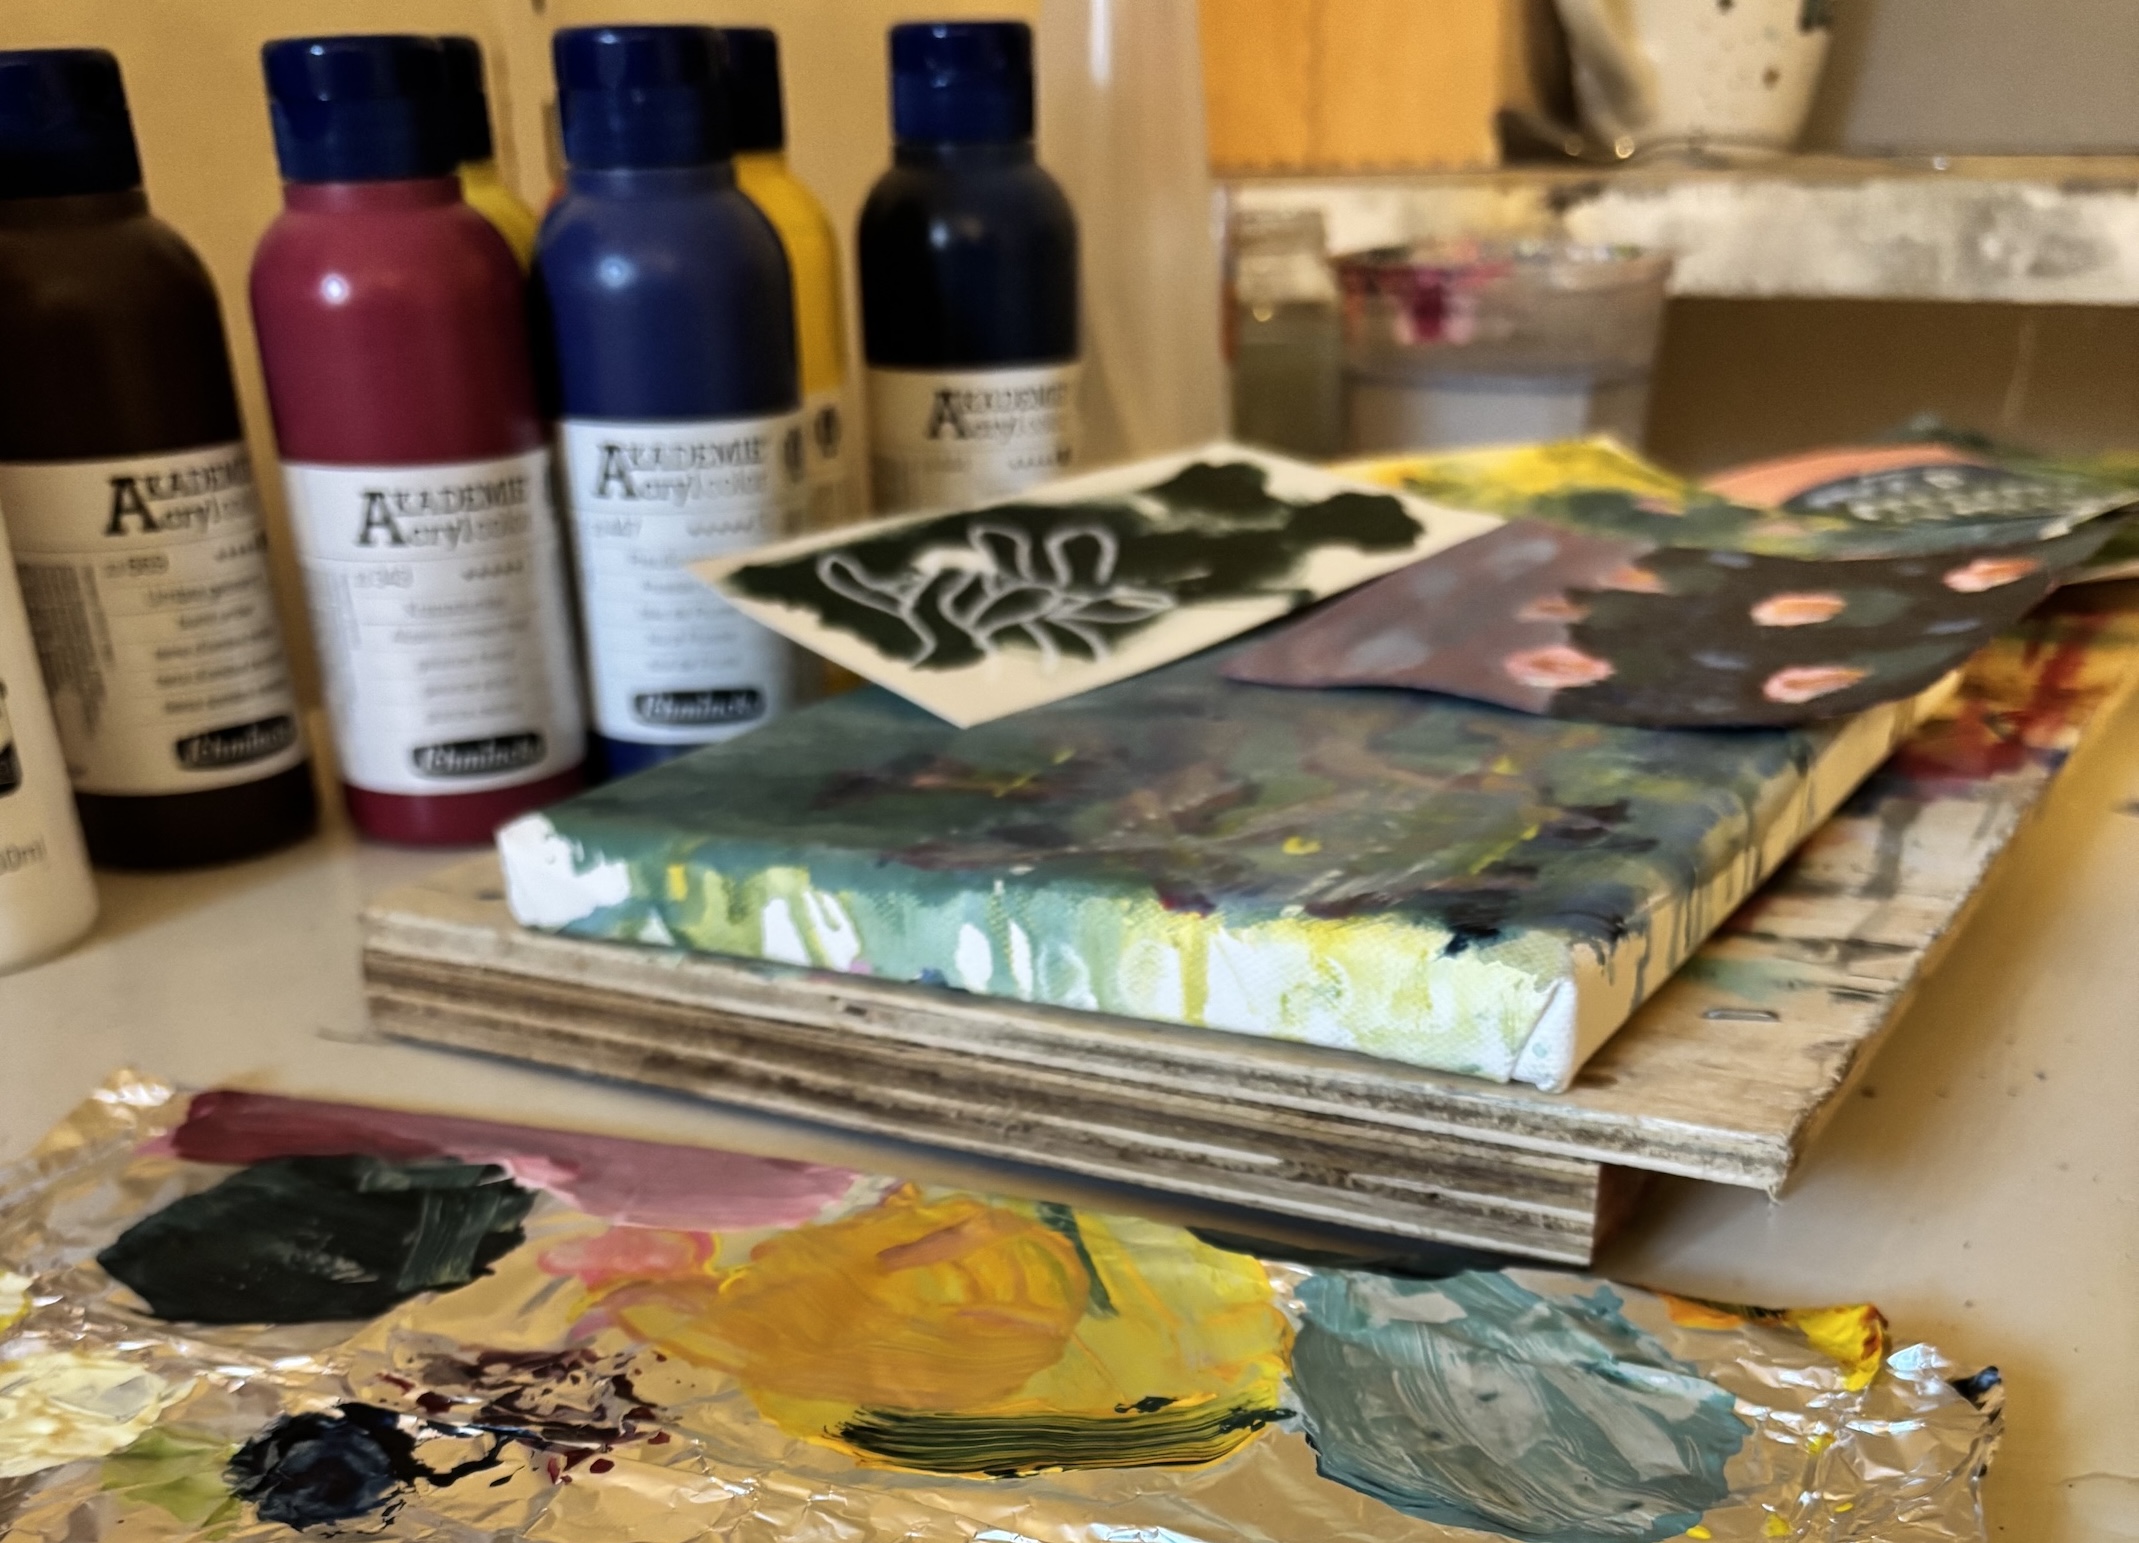
Atelierfoto: Acrylfarben, eine bemalte Leinwand und eine Palette aus Alufolie mit angemischten Farbtupfern

KI scraped Kunst, Daten, alles Mögliche und erstellt auf Knopfdruck neue Bilder, neue Texte, neuen Code. Ich nutze das, teilweise, und manchmal lasse ich mich von den Möglichkeiten auch überwältigen.

Ausgerechnet jetzt habe ich wieder mit dem Malen angefangen. Das mag nicht intuitiv erscheinen.

Mir sind meine eigenen Fähigkeiten wieder wichtiger geworden. Der Prozess, wie ich zu einem Ergebnis komme. Ich schreibe mehr, sammle Notizen und Ideen, lese wieder „statische” Bücher. Und ich male in einer Malgruppe, mit Menschen im selben Raum.

Was auf der Leinwand passiert

Ich klatsche Farbe aufs Papier oder auf die Leinwand und schaue, was passiert. Dieser Hintergrund sollte ein Teich werden, jetzt sieht es aus wie eine Unterwasserwelt. Der Fleck dort, das könnte eine Koralle sein. Hier noch eine Schicht drüber, ein heller Moment würde der Sache guttun.

Kein Ziel, kein Briefing. Ich folge dem, was schon da ist.

Der Modus, den ich kaum noch übe

Mein Arbeitstag besteht fast nur aus dem Gegenteil. Ich eröffne eine Richtung, ich gebe ein Ziel vor, ich bewerte, was zurückkommt. Die Vernünftige sein, die mit dem Überblick und der Strategie.

Das führt häufig zu guten Ergebnissen. Dazwischen liegt aber auch viel Überforderung, Überproduktion und Wahllosigkeit.

Beim Malen kann sich die Richtung unterwegs ändern, ohne dass ich das entscheide. Die Farbe läuft, eine Schicht deckt anders als gedacht. Der Fleck war kein Vorschlag, den ich abgerufen habe. Am Ende steht ein Prozess, der befriedigend war, und etwas, auf das ich stolz bin.

Woher soll das Urteil kommen?

Es heißt, ein wichtiger Skill bei der Nutzung von KI sei Taste. Geschmack, Urteilsvermögen, ein geschultes Auge.

Nur: Woher soll mein Urteil kommen, wenn ich kaum noch exploriere? Expertise entsteht durch Wiederholung und Übung.

Das ist kein neues Problem. Wer lange genug führt statt zu machen, verliert irgendwann das Gefühl für das Gemachte. Neu ist nur, wie früh man jetzt in diese Rolle kommt und wie wenig schulende Arbeit noch übrig bleibt.

Dazu passt ein Befund aus Science Advances: Mit KI-Ideen wurden Kurzgeschichten einzeln besser bewertet, ähnelten sich untereinander aber stärker. Individuell besser, gemeinsam ärmer. Das ist das Material, an dem ich mein Auge schule.

Beide Modi gibt es überall

So sauber getrennt ist das allerdings nicht, und an den Werkzeugen liegt es auch nicht. Ich nutze digitale Tools ebenso beim Malen. Ich fotografiere Zwischenstände ab und probiere mit Filtern herum, ich starte mit Fotos und male erst mal Outlines in Procreate.

Und ich lasse ein LLM meine Bilder analysieren. Das ist schräg, gebe ich zu. Ich habe dabei kein Ziel, ich will nur sehen, was zurückkommt. Manchmal bringt es mich auf Suchbegriffe: Namen aus der Kunstgeschichte, Werke, Stilrichtungen, auf die ich selbst nicht gekommen wäre.

Das Digitale ist also nicht weg. Es steht davor, dazwischen und danach. Nur nicht in dem Moment, in dem die Farbe auf die Leinwand kommt.
Weiterlesen →

Wie gesund wollen wir sein? Und wer gestaltet das eigentlich?

Auf meiner Überweisung stand „Weber Zeh Fraktur”. Gemeint war eine Weber-C-Fraktur. Jemand hat diktiert, jemand anderes hat abgetippt, dazwischen wurde aus einem Buchstaben ein Körperteil.

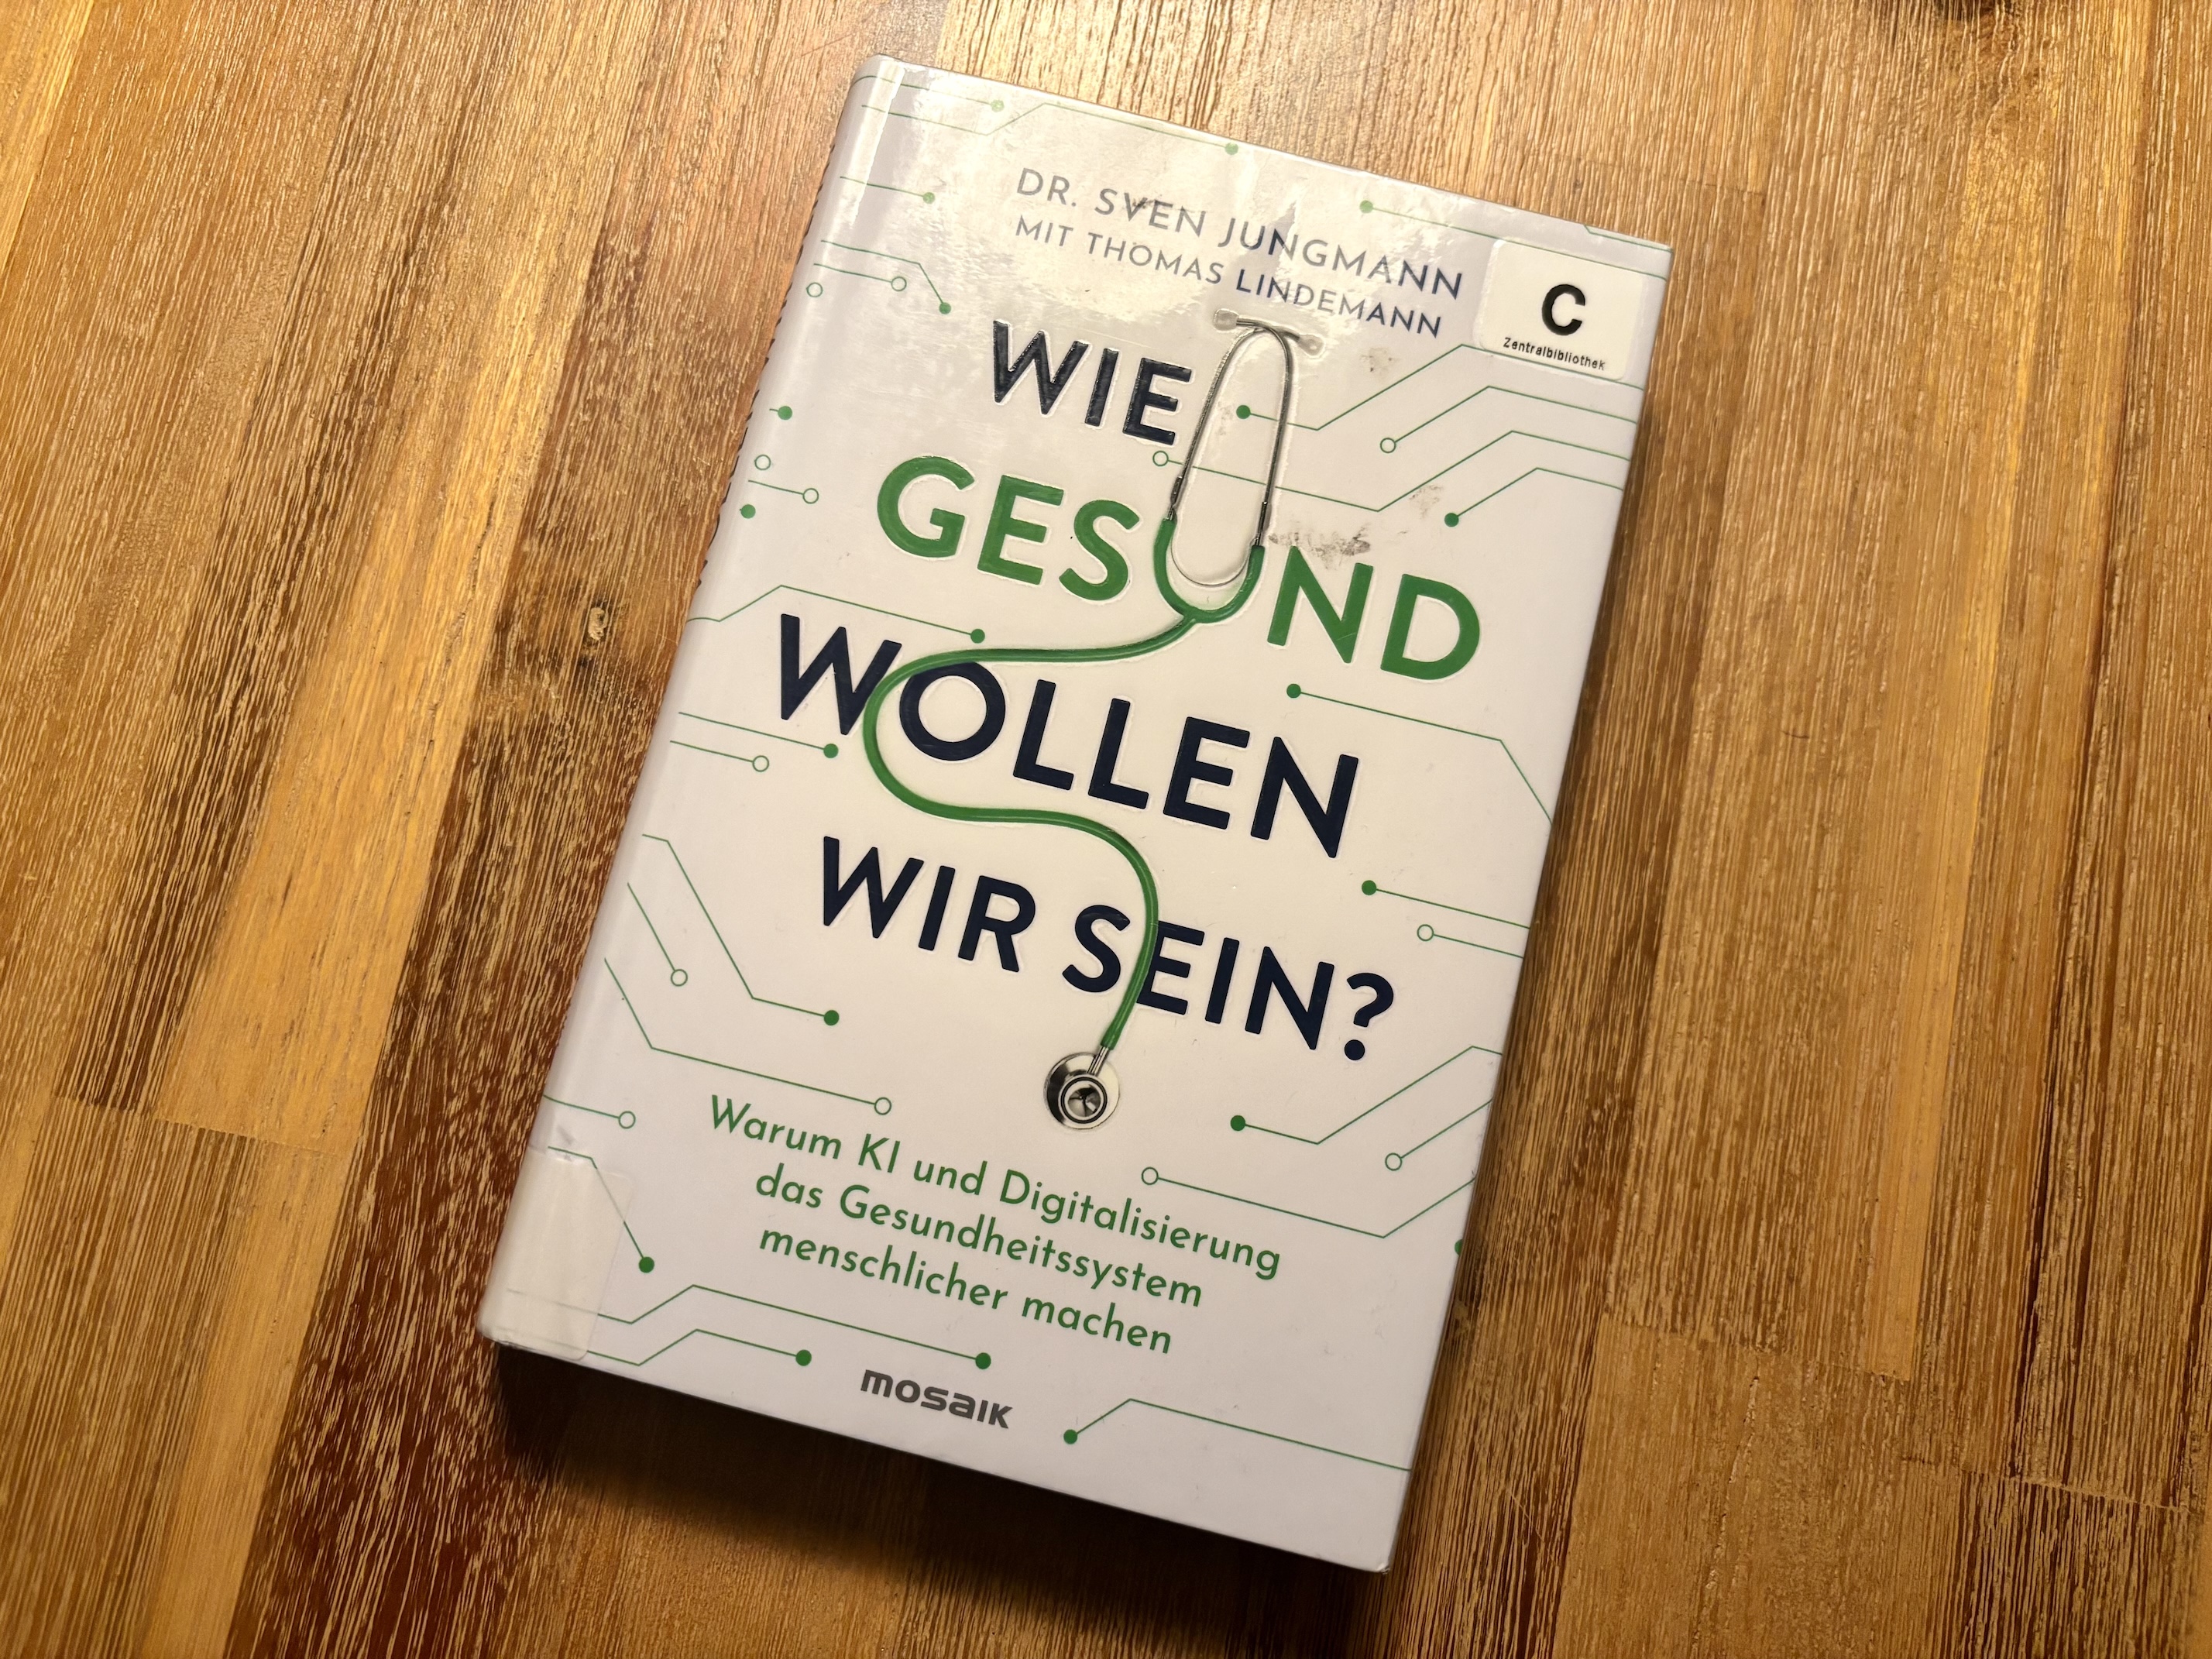
Buchcover von „Wie gesund wollen wir sein?" von Dr. Sven Jungmann mit Thomas Lindemann, mosaik Verlag

Solche und andere Momente sammeln Sven Jungmann und Thomas Lindemann in „Wie gesund wollen wir sein?” (Mosaik, 2024). Der Untertitel verspricht, dass KI und Digitalisierung das Gesundheitssystem menschlicher machen. Die Baustellen benennt das Buch richtig. Nur ist die Antwort darauf seltener Digitalisierung und KI, als der Titel glauben macht.

Der Ausgangspunkt stimmt: Wir werden realistisch nicht wesentlich mehr Ärztinnen und Ärzte ins System bekommen und auch nicht mehr Pflegekräfte. Dafür mehr alte Menschen und mehr Behandlungsbedarf. Wenn also Technik die Dokumentation übernimmt, bleibt wieder Zeit für die Menschen. So die Rechnung.

Neue Herausforderungen für die Gestaltung

Nur ist vieles von dem, was das Buch fordert, gar keine Frage von KI. Beispiel aus dem Kapitel zur Patientenakte: Die Akte warnt inzwischen so oft, dass die Warnungen meistens ignoriert werden. Alert Fatigue. Das ist kein Modellproblem, das ist ein Gestaltungsproblem. Zu viele Meldungen, keine Priorisierung, kein Blick dafür, unter welchem Druck jemand sie liest. So geht es mir an vielen Stellen im Buch. Sechs Bezeichnungen für einen Herzinfarkt in einem System. Diagnosen in meiner Akte, über die nie jemand mit mir gesprochen hat. Digitalisierung macht solche Probleme nicht kleiner, sie skaliert sie nur schneller.

Und die Rechnung mit der Zeit geht nur auf, wenn jemand sie schützt. Gesparte Dokumentationszeit kann in Zuwendung fließen. Sie kann auch in mehr Fälle pro Schicht fließen. Die Arbeit verdichtet sich seit Jahren, und Effizienzgewinne haben sich in diesem System selten von allein in Ruhe verwandelt. Es müsste also nicht nur ein Minimum geben, sondern auch ein Maximum.

Die Gegenwart holt das Buch schon ein

Wie schnell die Gegenwart ein Sachbuch einholt, zeigt die ePA. 2024 lautete das Urteil: gibt es, taugt nichts, wir brauchen einen digitalen Zwilling statt einer digitalen Aldi-Tüte. Zwei Jahre später ist die Nutzung Pflicht, und der Hausärzteverband beschreibt das Ergebnis als unsortierte PDF-Sammlung ohne Volltextsuche. Aldi-Tüte, jetzt flächendeckend.

Stark ist das Buch da, wo es aufhört, die Gegenwart zu beklagen, und erzählt, wie es sein könnte. Diese Szenarien hätte ich gern öfter gehabt. Und aktuell können wir ja alle dabei zugucken, wie sich das Thema verändert. Wenn jemand ein gesundheitliches Problem hat, ist eine Frage an ChatGPT oder Claude nicht weit und kann sogar hilfreich sein. Das beschreibt Jungmann auch in seinem Buch: Besonders bei der Erkennung von seltenen Krankheiten, bei der individuellen Begleitung und bei personalisierten Empfehlungen kann KI sehr hilfreich werden.

Eigenverantwortung setzt voraus, dass das System mitspielt

Die interessantere Forderung steht weiter hinten im Buch, und sie hat mit KI wenig zu tun: Eigenverantwortung. Nicht die Tablette und das Rezept, sondern ein aktiver Part in einem gemeinsamen Prozess. Dazu gehört ein Gedanke, den ich mitnehme. Der einzelne Termin bei der Hausärztin ist der falsche Maßstab. Was trägt, ist eine dauerhafte Begleitung aus Information, Personalisierung und Guidance. Entlassung ist vielleicht das falsche Konzept.

Nur setzt Eigenverantwortung voraus, dass das System mitspielt. Meine Uhr misst seit Jahren mit, und im System interessiert das niemanden. Meine Fitnessstudio-Mitgliedschaft habe ich bei der Kasse eingereicht und bis heute nicht erfahren, was aus den Punkten geworden ist. Meinen Gesundheitscheck schiebe ich seit Wochen vor mir her.

Ich soll meine Gesundheit selbst in die Hand nehmen. Womit denn?

Vielleicht schlage ich mich doch mal durch die ePA-Registrierung. Steht auch schon eine Weile auf der Liste. Vielleicht finde ich da ja etwas. Vielleicht auch nicht.

Weiterlesen →

Der Prototyp stand, bevor das Problem stand

TL;DR: In meinem UX-for-AI-Training habe ich mich dabei erwischt, Storyboard und Digital Twin zu überspringen und direkt zum Prototyp zu gehen. Nicht aus Faulheit, sondern weil die KI ihn sofort bauen konnte. Das Learning: KI-Geschwindigkeit ist ein Geschenk, wenn das Problem steht. Und eine Falle, wenn nicht.

Die Versuchung

Im Snowball Sprint Framework von Greg Nudelman kommt der Prototyp spät. Vorher stehen Problem Framing, Storyboard, Digital Twin, also die Phasen, in denen man herausfindet, ob man überhaupt das richtige Problem löst. Ich kenne diese Reihenfolge gut.

Und dann saß ich da, Claude neben mir, und der erste Prototyp war fertig, bevor ich wusste, welches Problem ich eigentlich lösen wollte. Warum warten? Das Ding war ja schon da. Klickbar. Es sah nach Fortschritt aus.

Claude Code baut den Misalignment Identifier als fertigen Klick-Prototyp, drei Stufen in einer einzigen HTML-Datei

Die Ironie

Mein erste Idee für ein Übungsprojekt war ausgerechnet ein Tool, das verfrühtes Commitment in Teams verhindern sollte: Annahmen sichtbar machen, bevor jemand anfängt zu bauen. Und beim Bauen dieses Tools ist mir exakt das passiert, wovor es warnen sollte. Ich habe die Beobachtung damals in meiner Doku festgehalten, als ehrlichen Gesprächsöffner. Heute lese ich sie als Diagnose.

Dass ich die Übung später beiseitegelegt habe, passt ins Bild. Der Prototyp war nicht schlecht. Er war nur die schnelle Antwort auf eine Frage, die ich noch gar nicht geprüft hatte. Und weil er so schnell so echt aussah, hat er diese Frage zementiert, statt sie zu stellen.

Was die alten Phasen eigentlich leisten

Storyboard und Digital Twin und natürlich auch User Research fühlen sich langsam an, wenn die KI in derselben Zeit drei Prototypen baut. Aber ihre Langsamkeit war nie ein Bug. Sie ist die Zeit, in der man denkt. Die Reibung dieser Phasen zwingt dazu, Annahmen auszusprechen, bevor sie in Code gegossen werden.

Mein Learning

Die Frage ist nicht, wie schnell die KI bauen kann, sondern ob ich schon weiß, was gebaut werden soll. Das kann mir keine KI abnehmen, denn sie baut mit demselben Enthusiasmus am falschen Problem wie am richtigen.

Es ist dieselbe Frage wie beim Farbwechsel auf meiner Portfolio-Seite, nur eine Phase früher: Dort war die Delegation zu groß, hier war sie zu schnell. Mehr dazu: Ein Prompt, ein gelöschter Branch und eine arbeitslose Aubergine. In beiden Fällen dieselbe Antwort: Der Mensch bestimmt das Tempo, nicht das Tool.

Weiterlesen →

Ein Prompt, ein gelöschter Branch und eine arbeitslose Aubergine

TL;DR: Ich wollte das Farbschema meiner Portfolio-Website mit Claude Design und Claude Code umbauen. Der erste Versuch mit einem großen, KI-generierten Prompt endete mit einem gelöschten Branch. Der zweite Versuch in kleinen, selbst angeleiteten Schritten hat funktioniert. Das Learning: Nicht die KI war das Problem, sondern die Größe der Aufgabe und die fehlende Kontrolle dazwischen.

Der Plan klang gut

Meine Portfolio-Website ist mein Playground für AI-assisted Design und Coding. Sie basiert auf Astro. Als Vorarbeit hatte ich das Design in einer früheren Session bereits auf Design Tokens umgestellt, die Farben liegen seitdem in einem schlichten Token-File. Naming Conventions etc. noch nicht perfekt, aber ein Anfang.

tokens.css mit Farb-, Typo- und Spacing-Tokens im Root-Block

Testweise habe ich das Design mit Claude Design überarbeitet: neue Primary Color, neue Secondary Color. Sah gut aus. Jetzt die Frage, wie bekomme ich das am schnellsten in meinen Code? Also habe ich Claude Design gebeten, gleich noch den Prompt für Claude Code zu schreiben.

Claude Design formuliert den Übergabe-Prompt für Claude Code, daneben die Portfolio-Vorschau mit der neuen Primary Color Aubergine

Der Prompt war lang, aber alles klang plausibel. Also alles rüber an Claude Code.

Rödeln, rödeln, rödeln

Und das Ding rödelt. Und rödelt. Und rödelt. Irgendwann dachte ich: Das wird offensichtlich nix. Wurde es auch nicht.

Ein Beispiel: Die neue Primary Color Aubergine Dark wurde nirgends genutzt. Sie saß im Token-File und wartete auf ihren Einsatz. Vergeblich. Logisch eigentlich, denn vorher gab es auch kein Sage Dark. Woher soll Claude Code wissen, wo ein Token eingesetzt wird, das es strukturell noch nie gab?

Erst da fiel mir auf, warum mir das beim Durchlesen nicht aufgefallen war: Ich hatte die Lücken im Prompt mit meinem Wissen über die Codebase ganz automatisch aufgefüllt. Claude Code konnte das nicht. Claude Design kennt meine Codebase nicht, die kenne nur ich. Der Prompt hat eine Struktur vorausgesetzt, die in meinem Code nicht existierte.

Branch gelöscht, Schritt zurück.

Zweiter Versuch: Struktur vor Farbe

Diesmal habe ich Claude Code selbst angeleitet, Schritt für Schritt:

Erst die bestehende Palette erweitern: Sage bekam Light- und Dark-Varianten. Dann die Tokens konsistent im gesamten Code nutzen. Und erst danach der Wechsel auf die neue Farbpalette. Einfache Struktur, einfacher Switch. Der eigentliche Farbwechsel, an dem der erste Versuch gescheitert war, dauerte am Ende kaum noch etwas. Auch die Aubergine kam endlich zum Einsatz.

Und später, in einem weiteren Schritt: Wechsel von Sage Dark zu Primary Dark. Denn ich wechsle meine Farben testweise so oft wie meine Unterhosen, also muss das Naming der Tokens semantisch sein. Dazu gehört auch, den Code zu überprüfen: Wo werden noch hart codierte Werte verwendet? Für eine saubere Nutzung der Tokens ist das der klassische Stolperstein.

Grep-Ergebnis: hardcodierte font-size-Werte über mehrere Astro-Seiten verteilt, statt konsistent auf Tokens zu verweisen

Meine Learnings

Refactor first, then change. Erst die Struktur sauber machen, dann die eigentliche Änderung. Der Farbwechsel war trivial, sobald die Token-Struktur stimmte. Das Scheitern davor war kein Claude-Problem, sondern ein Reihenfolge-Problem. Claude hätte dieses Vorgehen sogar anleiten können, wenn ich danach gefragt hätte. Aber zu wissen, wann man danach fragt, ist der Job des Menschen.

Zu große Tasks runterbrechen. Und zwar so weit, dass ich jedes Ergebnis selbst beurteilen kann. Das ist für mich das eigentliche Kriterium für „zu groß”: nicht die Zeilenzahl, sondern ob ich noch prüfen kann, was passiert ist.

Plan, Code, Judge. Und wieder von vorn. Nicht am Ende einmal kontrollieren, sondern nach jedem Schritt.

KI-zu-KI-Übergaben brauchen einen Menschen dazwischen. Der Prompt von Claude Design klang plausibel, weil ich ihn mit meinem Kontext gelesen habe. Claude Code hatte diesen Kontext nicht. Wer die Codebase kennt, muss die Übergabe machen, nicht die KI.

Git ist das Sicherheitsnetz. Änderungen im Code gehen wahnsinnig schnell. Versionierung ist für meine Experimente aktuell wichtiger denn je.

Warum das mehr ist als ein Farbwechsel

Das hier war ein Farbwechsel auf einer Portfolio-Seite, überschaubarer geht es kaum. Aber die Muster sind dieselben wie in jeder Mensch-KI-Zusammenarbeit: Aufträge so zuschneiden, dass ein Mensch das Ergebnis noch beurteilen kann. Wissen, wo bei Übergaben Kontext verloren geht. Und entscheiden, wann der Prozess einen Plan braucht, bevor jemand losrödelt. Genau diese Fragen stellen sich Teams gerade überall, wo KI in die Arbeit einzieht. Meine Website ist für mich der Ort, das end-to-end zu üben. Und manchmal, eigentlich eher öfter, geht das halt schief.

Weiterlesen →

Zwölf Wochen UX for AI: was learning by doing mir gebracht hat

TL;DR: Zwölf Wochen UX-for-AI-Training, ein selbstgebautes KI-Produkt und eine Lektion, die am Ende größer war als jede einzelne Methode: Ich will mich von der KI nicht abhängen lassen, doch das passiert bei der neuen Geschwindigkeit super schnell. Ich habe als Ein-Frau-Team, mit KI als Unterstützung, ein KI-getriebenes Produkt konzipiert, gebaut und getestet. Hier kommt der Rückblick auf den Ansatz und die Methoden. Was mich das Bauen über Verantwortung in regulierten Health-Produkten gelehrt hat, folgt in einem weiteren Post.

Der Ansatz

Gearbeitet habe ich entland des Trainings mit dem Snowball Sprint Framework von Greg Nudelman: Problem Framing, Prototyping, Testing und Vibe Coding, end-to-end bis zum eigenen RAG-Prototyp.

UX for AI — Buch von Greg Nudelman

Vieles war altbekannt, aber bekommt durch die direkte Kollaboration mit einer AI einen neuen Dreh. Storyboarding und Wireframing kannte ich längst, aber als Kontext für Claude waren meine Scribbles nochmal anders nützlich. Die echte Überraschung war der Digital Twin: Dieses Mapping von Input, Schema und Output hätte in früheren Projekten ganze Teams sehr viel schneller auf einen gemeinsamen Stand gebracht. Die Value Matrix dagegen fand ich wackelig, definite Zahlen auf einem ganzen Berg von Annahmen versprechen eine falsche Form von Sicherheit.

Und das Prototyping ist am Anfang absurd schnell. Fast zu schnell. Claude baut schon den ersten Prototyp, während ich eigentlich noch dabei bin herauszufinden, welches Problem ich überhaupt lösen will. Der schwierige Teil kommt danach: auf Kurs zu bleiben.

Eine spezifische Variante, nicht das Evangelium

Gregs Mischung aus Hands-on-KI, Scribble-Prototyping und schnellem Testen mochte ich wirklich. Trotzdem ist es eine sehr spezifische Lean-Variante, und das sollte man dazusagen. Seine zentrale These lautet: Die UX-Zunft hängt zu sehr an Figma, das ohnehin gerade irrelevant wird. Den Punkt verstehe ich. Nur deckte er sich nicht mit dem, was ich im Kurs gesehen habe. Die Teilnehmenden waren durch die Bank breit aufgestellt, alles andere als pixelverliebt.

Das Produkt: ein Responsible Digital Health Checker

Wer das Tool nutzt, gibt die Beschreibung eines KI-Health-Features ein und bekommt eine Einschätzung zu den rechtlichen Anforderungen zurück, auf Basis von EU AI Act, MDR, DiGA-Leitlinien und weiteren Normen. Dazu sucht ein kleiner Websearch-Agent nach aktuellen Debatten und hängt sie als „Diskussionen, die man verfolgen sollte” an.

Output des Responsible Digital Health Checkers: Feature Summary, Regulatory Signals (EU AI Act, MDR, DiGA) und DSGVO-Pflichten

Und so sieht der Checker als schematischer Digital Twin aus:

Digital Twin: Input, LLM-Schematic, LLM-Output, Agent-Layer und Overall Output des Responsible Digital Health Checkers

Doch ich habe nicht nur zu meinem eigenen Workflow mit AI etwas gelernt. Auch in Bezug auf AI bei regulierten Produkten habe ich etwas mitgenommen: Hier ist es besonders wichtig, dass der Mensch in Führung bleibt, denn die finale Entscheidung kann (oder sollte) AI nicht treffen. Das macht Transparenz zum wichtigsten UX-Prinzip. Dazu mehr in einem neuen Post.

Alle Artikel dieser Serie

Die einzelnen Schritte habe ich während des Trainings dokumentiert — auf englisch und in chronologischer Reihenfolge:

  1. From Problem Finding to Prototyping too fast
  2. Evaluating some ideas
  3. Creating a Storyboard and Digital Twin
  4. Creating the Value Statement
  5. Grounding the idea on RAG
  6. From Wireframe Scribble to Prompt Template
  7. Vibe Coding: Give it a try by creating a Kanban board
  8. Vibe Coding an LLM-based demo project: Life Clock
  9. Vibe Coding my Responsible Digital Health Checker as a local prototype
  10. RAG Refactoring: Better Results Start With Better Context
  11. Adding the agentic layer: a web-lookup agent for live regulatory context
Weiterlesen →